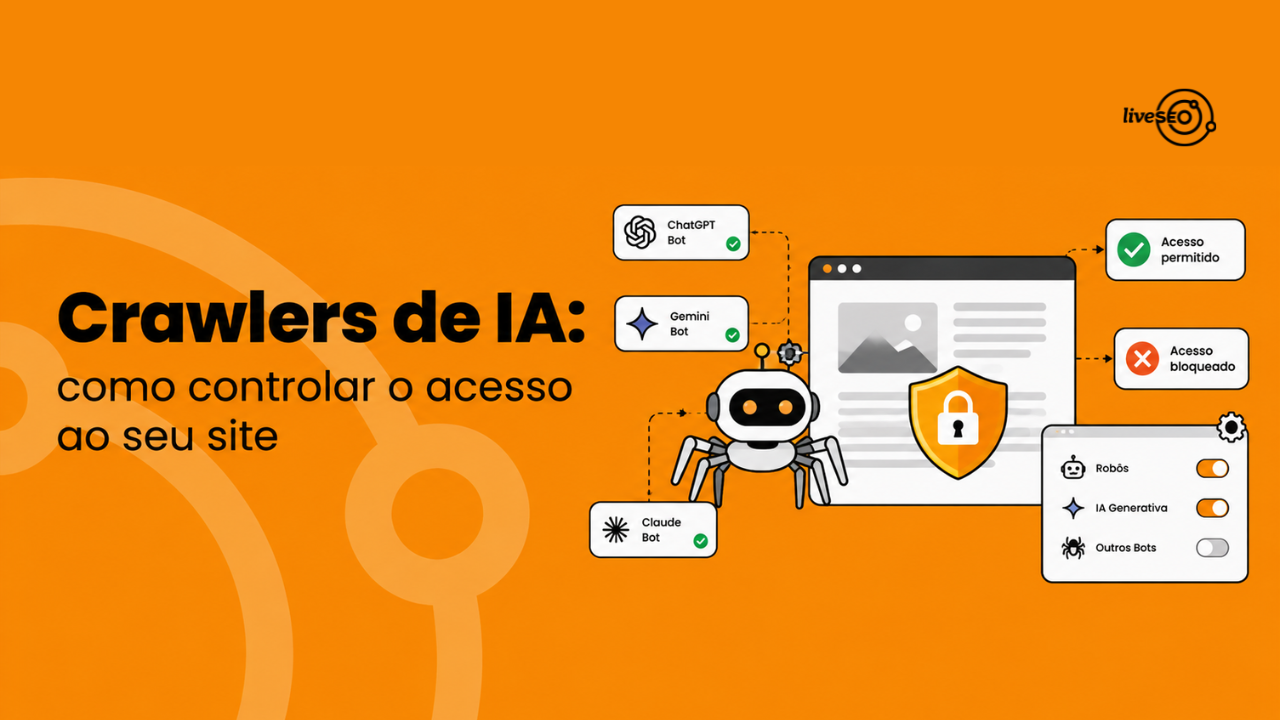
O robots.txt deixou de ser apenas uma configuração técnica para mecanismos de busca tradicionais. Com a expansão dos sistemas de IA, ele também passou a definir quais crawlers podem acessar o conteúdo de um site e quais sistemas podem ter contato com essas informações.
O problema é que muitos sites ainda mantêm regras criadas antes da popularização da busca generativa, incluindo bloqueios amplos para crawlers de IA. Dependendo da configuração, isso pode impedir o acesso de sistemas que recuperam conteúdo para experiências de busca e respostas generativas, enquanto permite o acesso de outros rastreadores com finalidades diferentes.
Por isso, a questão não é simplesmente bloquear ou liberar crawlers de IA. É entender quem está acessando o conteúdo, para qual finalidade e qual impacto essa decisão pode ter na visibilidade da marca.
Neste texto, você vai entender como funcionam os principais crawlers de IA, qual é o papel de cada um e como configurar o robots.txt de acordo com a estratégia de visibilidade do seu site.
O que são crawlers de IA e por que eles importam para o SEO?
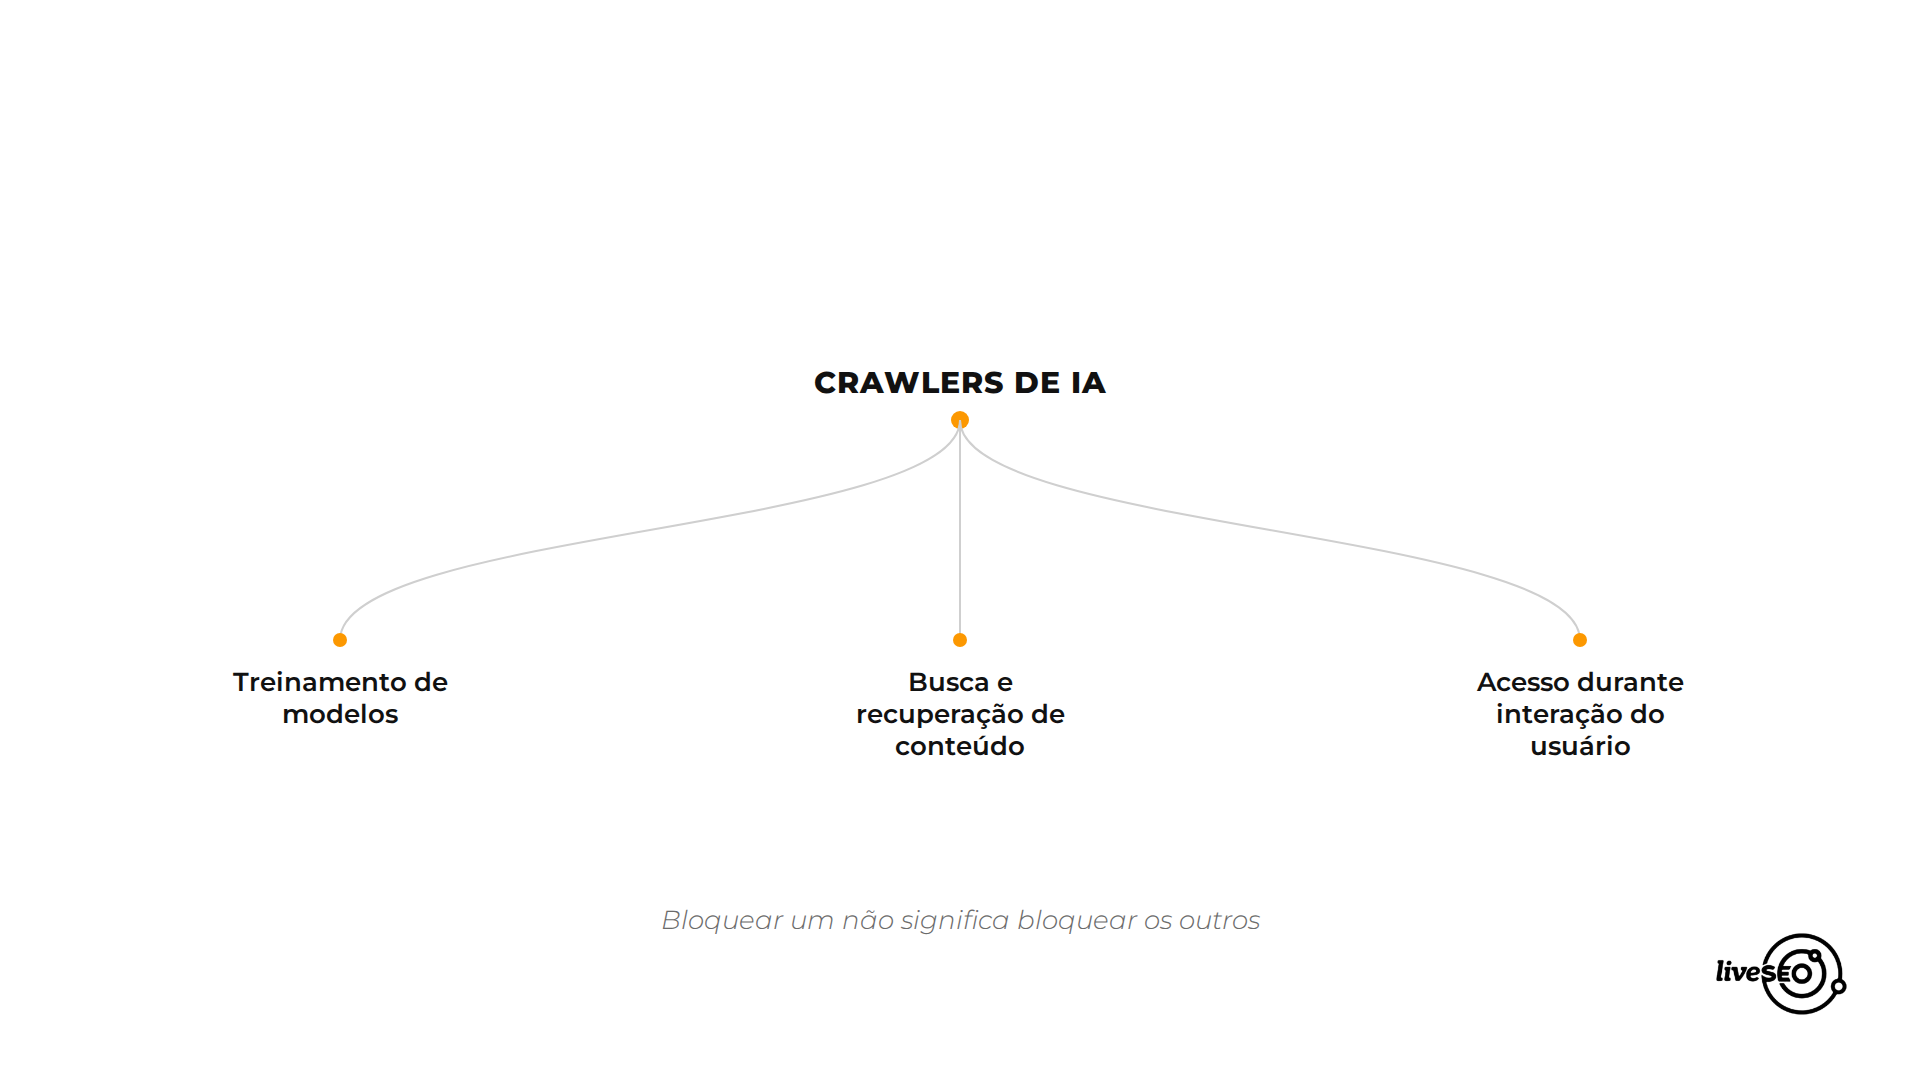
Crawlers de IA são sistemas automatizados que acessam páginas da web para coletar, analisar ou recuperar informações. Embora funcionem de maneira semelhante aos crawlers dos mecanismos de busca tradicionais, suas finalidades podem ser diferentes: alguns estão relacionados ao treinamento de modelos, enquanto outros participam de experiências de busca, recuperação de informações ou funcionalidades de agentes.
Essa diferença importa para o SEO porque permitir ou bloquear um crawler pode afetar a capacidade de determinados sistemas de encontrar e utilizar o conteúdo de um site. Em um cenário em que mecanismos de IA também participam da descoberta e da jornada de busca, o robots.txt passa a fazer parte da estratégia de visibilidade.
Essa diferença entre os crawlers também ajuda a entender um ponto maior: ser acessível por uma IA não significa necessariamente ser citado por ela. Para entender o que influencia essa visibilidade, confira “AI Visibility: estratégias para ser citado em cada IA“.
Quais crawlers de IA podem acessar seu site?
Nem todo crawler de IA tem a mesma função. Alguns estão associados ao treinamento de modelos, enquanto outros participam de mecanismos de busca, recuperação de informações ou funcionalidades de agentes. Essa diferença é importante porque bloquear um crawler não produz necessariamente o mesmo efeito em todos os casos.
Antes de alterar o robots.txt, portanto, vale entender a finalidade de cada crawler e o papel que ele pode desempenhar na descoberta ou recuperação do conteúdo.
| Crawler | Empresa | Principal finalidade | Relação com visibilidade em IA |
|---|---|---|---|
| GPTBot | OpenAI | Coleta de conteúdo para desenvolvimento e treinamento de modelos | Não deve ser tratado automaticamente como crawler de busca |
| OAI-SearchBot | OpenAI | Rastreamento para resultados de busca do ChatGPT | Pode ter relação direta com a descoberta de conteúdo no ChatGPT |
| ChatGPT-User | OpenAI | Acesso a páginas solicitado durante uma interação do usuário | Permite que o ChatGPT acesse conteúdo para responder a determinadas consultas |
| ClaudeBot | Anthropic | Rastreamento e coleta de conteúdo para sistemas da Anthropic | A finalidade deve ser considerada separadamente de crawlers voltados à busca |
| PerplexityBot | Perplexity | Rastreamento de páginas para o mecanismo de busca da Perplexity | Tem relação direta com recuperação de conteúdo em respostas da Perplexity |
| Google-Extended | Controle do uso de conteúdo por determinados produtos de IA do Google | Não é um crawler independente; funciona como controle de acesso para determinados usos | |
Bloquear crawlers de IA pode afetar sua visibilidade?
Bloquear um crawler de IA não significa bloquear todos os usos que uma empresa faz de inteligência artificial. Alguns estão relacionados ao treinamento de modelos, enquanto outros participam da busca, recuperação de informações ou acesso a páginas durante uma interação.
Por isso, a decisão de bloquear precisa estar relacionada ao objetivo da marca. Impedir o uso do conteúdo para treinamento é diferente de impedir que ele seja encontrado e recuperado em experiências de busca por IA.
Antes de adicionar uma regra ao robots.txt, vale responder: você quer impedir o uso do conteúdo para treinamento ou também quer impedir que ele seja encontrado em buscas e respostas generativas? Uma regra ampla pode restringir acessos que a empresa não pretendia bloquear.
Como configurar o robots.txt para cada estratégia
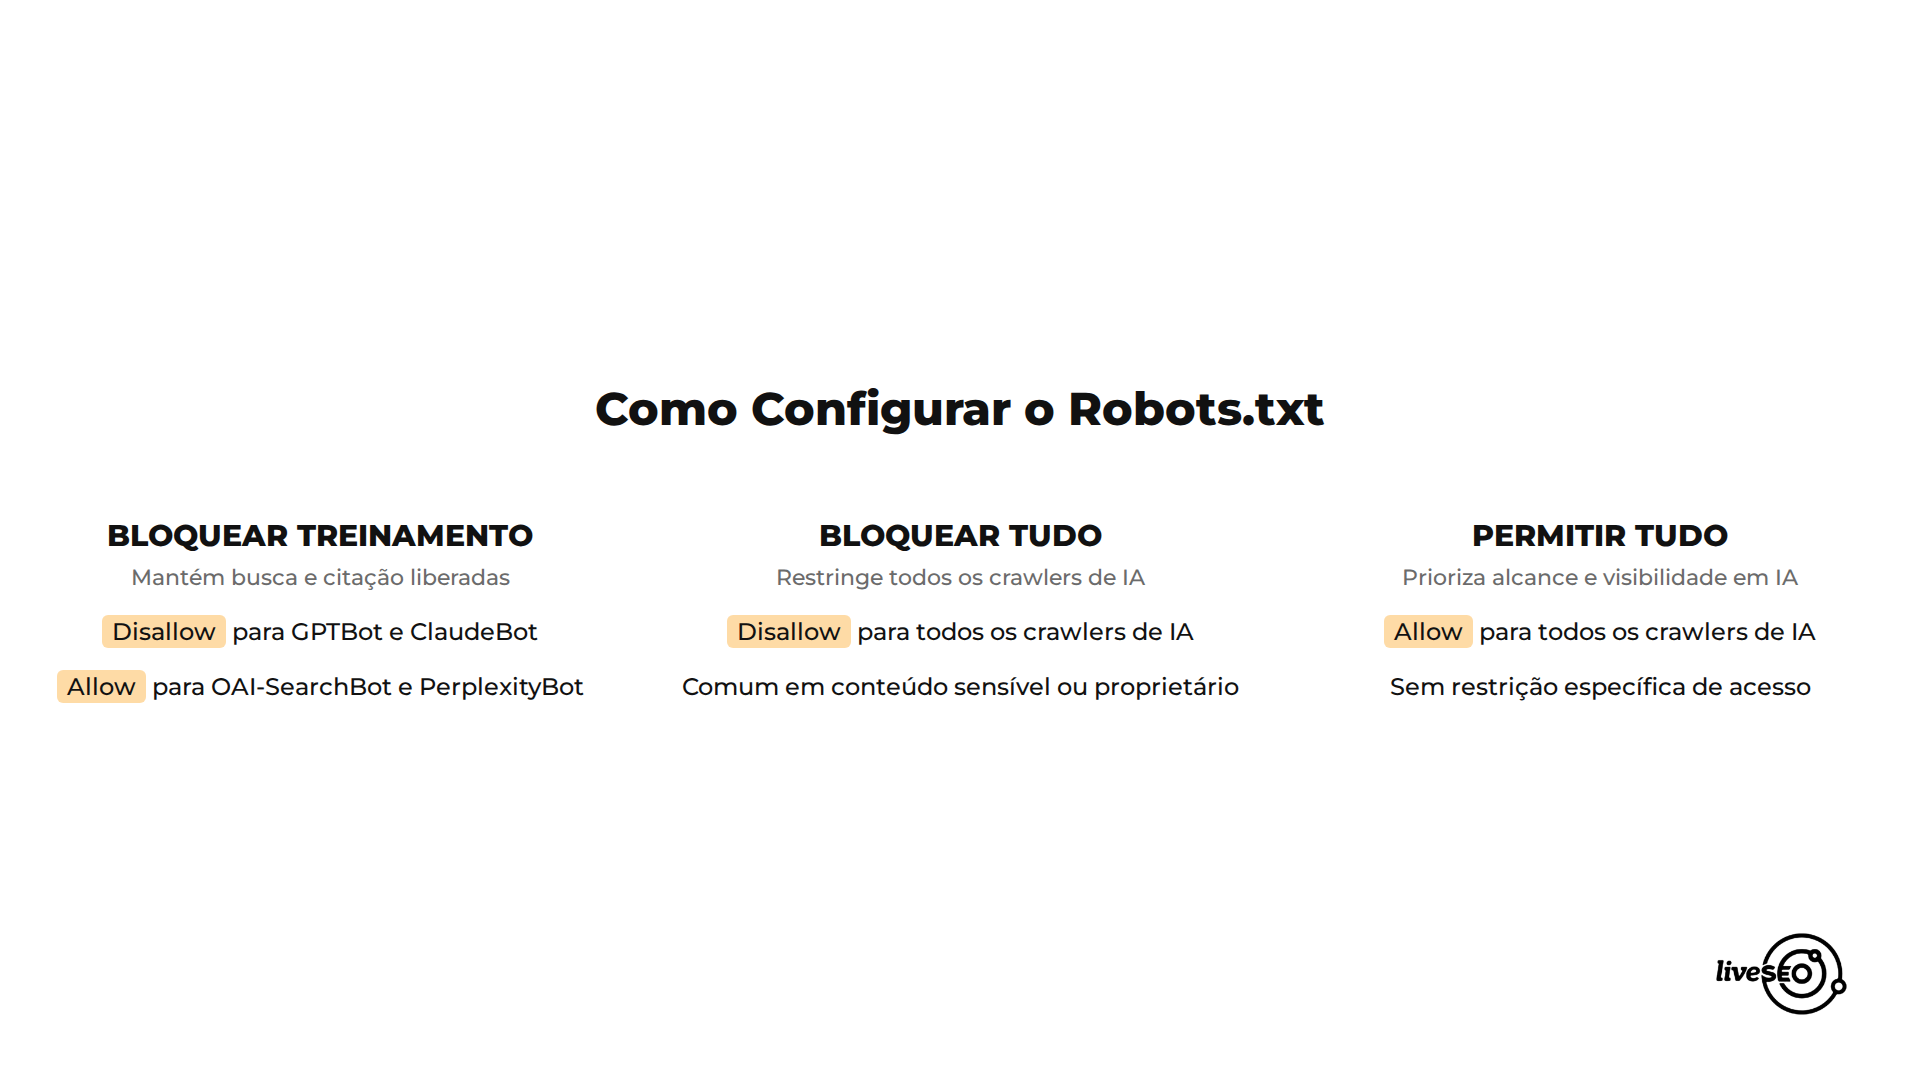
Com a tabela de referência em mãos, o próximo passo é definir quais acessos a empresa quer permitir ou bloquear e traduzir essa decisão em regras no robots.txt. Não existe uma configuração universal. A escolha depende do equilíbrio entre visibilidade em IA, controle sobre o uso do conteúdo e objetivos de negócio.
Estratégia 1: bloquear treinamento e permitir busca e citação
Essa opção faz sentido para sites que querem manter a possibilidade de aparecer em experiências de busca e respostas de IA, mas desejam restringir o acesso de crawlers associados ao treinamento de modelos.
# Bloquear crawlers de treinamento
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: CCBot
Disallow: /
User-agent: Applebot-Extended
Disallow: /
# Permitir crawlers de busca e recuperação
User-agent: OAI-SearchBot
Allow: /
User-agent: ChatGPT-User
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: Claude-User
Allow: /
User-agent: PerplexityBot
Allow: /
User-agent: Perplexity-User
Allow: /
A lógica é separar acesso para treinamento de acesso para busca e recuperação. Bloquear um não significa necessariamente bloquear o outro.
Estratégia 2: bloquear todos os crawlers de IA
Essa abordagem pode fazer sentido quando a prioridade é restringir o acesso ao conteúdo por sistemas de IA, independentemente da finalidade. É uma decisão mais comum em sites com informações sensíveis, conteúdo proprietário ou uma política específica de negócio ou jurídica sobre esse tipo de acesso.
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Disallow: /
User-agent: ChatGPT-User
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Claude-SearchBot
Disallow: /
User-agent: Claude-User
Disallow: /
User-agent: PerplexityBot
Disallow: /
User-agent: Perplexity-User
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: CCBot
Disallow: /
User-agent: Applebot-Extended
Disallow: /
Aqui, o trade-off é direto: quanto mais acessos forem restringidos, menor tende a ser a capacidade dos sistemas bloqueados de encontrar e recuperar o conteúdo.
Estratégia 3: permitir crawlers de IA
Essa opção pode ser adotada por sites que priorizam alcance e visibilidade em experiências de IA e não possuem uma restrição específica ao acesso desses agentes.
User-agent: GPTBot
Allow: /
User-agent: OAI-SearchBot
Allow: /
User-agent: ChatGPT-User
Allow: /
User-agent: ClaudeBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: Claude-User
Allow: /
User-agent: PerplexityBot
Allow: /
User-agent: Perplexity-User
Allow: /
User-agent: Google-Extended
Allow: /
Sintaxe básica: como o robots.txt é lido
Para adaptar os exemplos acima, é importante entender a lógica básica da sintaxe. Cada bloco começa com User-agent, que identifica o crawler ao qual as regras se aplicam. Disallow: / bloqueia o acesso a todo o site, enquanto Allow: / libera esse acesso.
Também é possível restringir apenas partes específicas do site. Por exemplo, Disallow: /admin/ impede o acesso à pasta /admin/, mantendo o restante do site disponível para aquele crawler. Cada User-agent deve ter seu próprio bloco de regras, mesmo quando a instrução é igual à de outro crawler.
Robots.txt garante que o crawler vai obedecer?
Não necessariamente, o robots.txt funciona como uma orientação para crawlers que seguem o protocolo, mas não é uma barreira técnica de acesso. Provedores como OpenAI, Anthropic e Google documentam que seus crawlers respeitam essas regras, mas isso não significa que todo crawler em circulação fará o mesmo. Além disso, qualquer script pode se identificar com um User-agent diferente.
Quando o objetivo é impedir o acesso de forma efetiva, e não apenas declarar uma preferência, é necessário combinar o robots.txt com outras camadas de controle, como regras de servidor, WAF ou ferramentas de gestão de bots.
Como monitorar o que os crawlers de IA estão fazendo no seu site
Depois de configurar o robots.txt, é importante acompanhar se as regras estão sendo respeitadas e se a estratégia está produzindo o efeito esperado. A análise dos logs do servidor por user-agent permite identificar quais crawlers estão acessando o site e com que frequência. Ferramentas de analytics também podem ajudar a separar o tráfego proveniente de sistemas de IA do tráfego orgânico tradicional.
Faça também revisões periódicas do arquivo: novos crawlers podem surgir, enquanto os existentes podem mudar de nome, finalidade ou comportamento.
Acompanhar os crawlers ajuda a entender o que está acontecendo nos bastidores, mas uma boa estratégia exige olhar para a saúde técnica do site como um todo. Saiba como fazer isso em “Auditoria SEO: como fazer e quais ferramentas utilizar“.
Antes de copiar qualquer regra, avalie quais crawlers fazem sentido para o objetivo do seu negócio, monitore os acessos e revise a configuração conforme o cenário de busca evolui.
Mais do que liberar ou bloquear bots, o desafio agora é entender como sua marca está sendo encontrada, recuperada e citada nos novos ambientes de busca.
Quer avançar nessa estratégia? Continue com o conteúdo “Generative Engine Optimization (GEO): o que é e como ajustar suas estratégias?” e entenda como adaptar o SEO para aumentar a visibilidade da sua marca nos mecanismos generativos.