Um modelo de IA não precisa responder apenas com aquilo que aprendeu durante o treinamento. Em várias aplicações que já usamos hoje, de assistentes de busca a chatbots corporativos, o sistema primeiro consulta fontes externas, recupera os trechos mais relevantes e só então usa esse material para construir a resposta.
Se uma IA precisa recuperar informações antes de responder, surge uma pergunta que interessa diretamente a quem trabalha com visibilidade digital: o que faz um conteúdo ser encontrado, recuperado e considerado relevante nesse processo?
É nesse ponto que entra o RAG (Retrieval-Augmented Generation). Neste conteúdo, vamos explicar como esse mecanismo funciona, por que ele mudou a forma como as IAs acessam informações e o que isso revela sobre a nova lógica de descoberta e recuperação de conteúdo, uma base importante para entender as discussões atuais sobre GEO (Generative Engine Optimization).
O que é RAG?
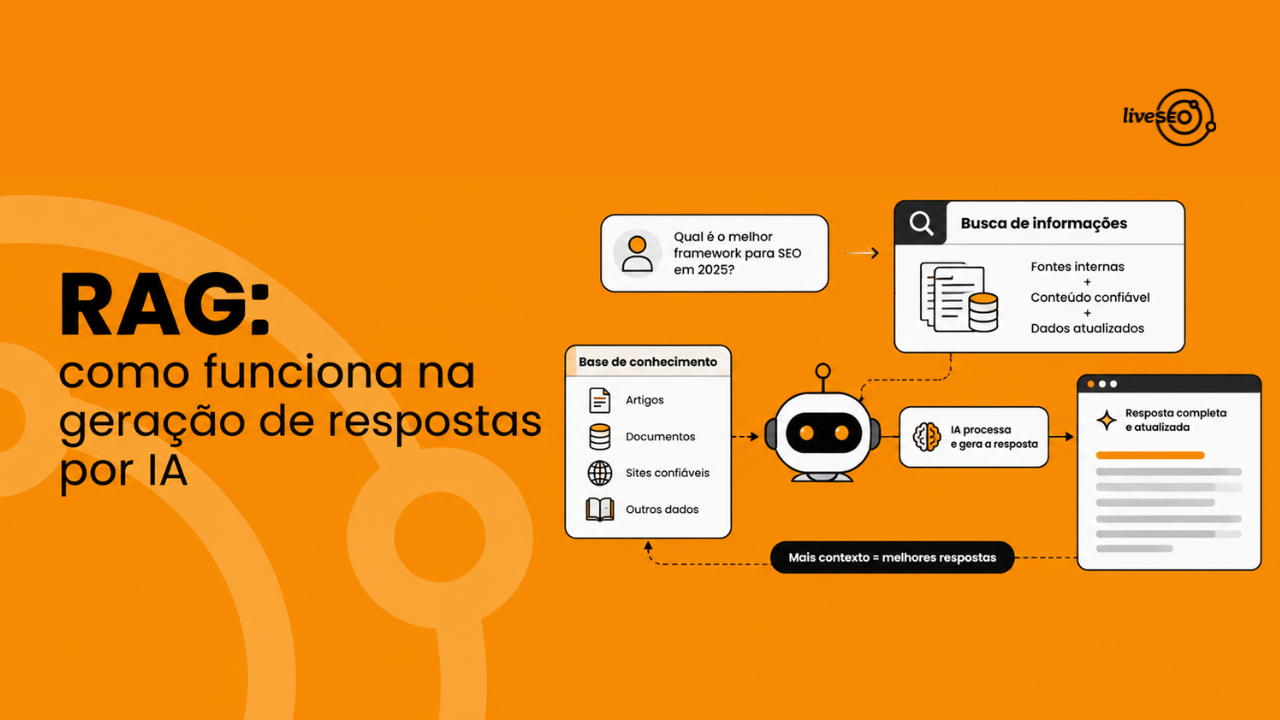
RAG é a combinação de dois processos: recuperação de informação e geração de resposta. Na prática, o sistema busca informações em fontes externas antes de gerar uma resposta, em vez de depender exclusivamente do conhecimento adquirido durante o treinamento do modelo.
Um modelo pode responder apenas com base no que aprendeu durante o treinamento. Nesse caso, suas respostas dependem do conhecimento disponível até aquele período. Já um sistema com RAG pode consultar bases de conhecimento, documentos, bancos de dados ou páginas da web para recuperar informações relevantes antes de responder.
Um exemplo ajuda a visualizar esse processo. Imagine alguém perguntando a um assistente de IA qual foi o crescimento do tráfego de IA para e-commerces em 2025. Um sistema com RAG pode interpretar a consulta, buscar documentos relacionados ao tema, identificar os trechos mais relevantes, fornecer esse contexto ao modelo e, só então, gerar a resposta.
Como funciona o RAG?
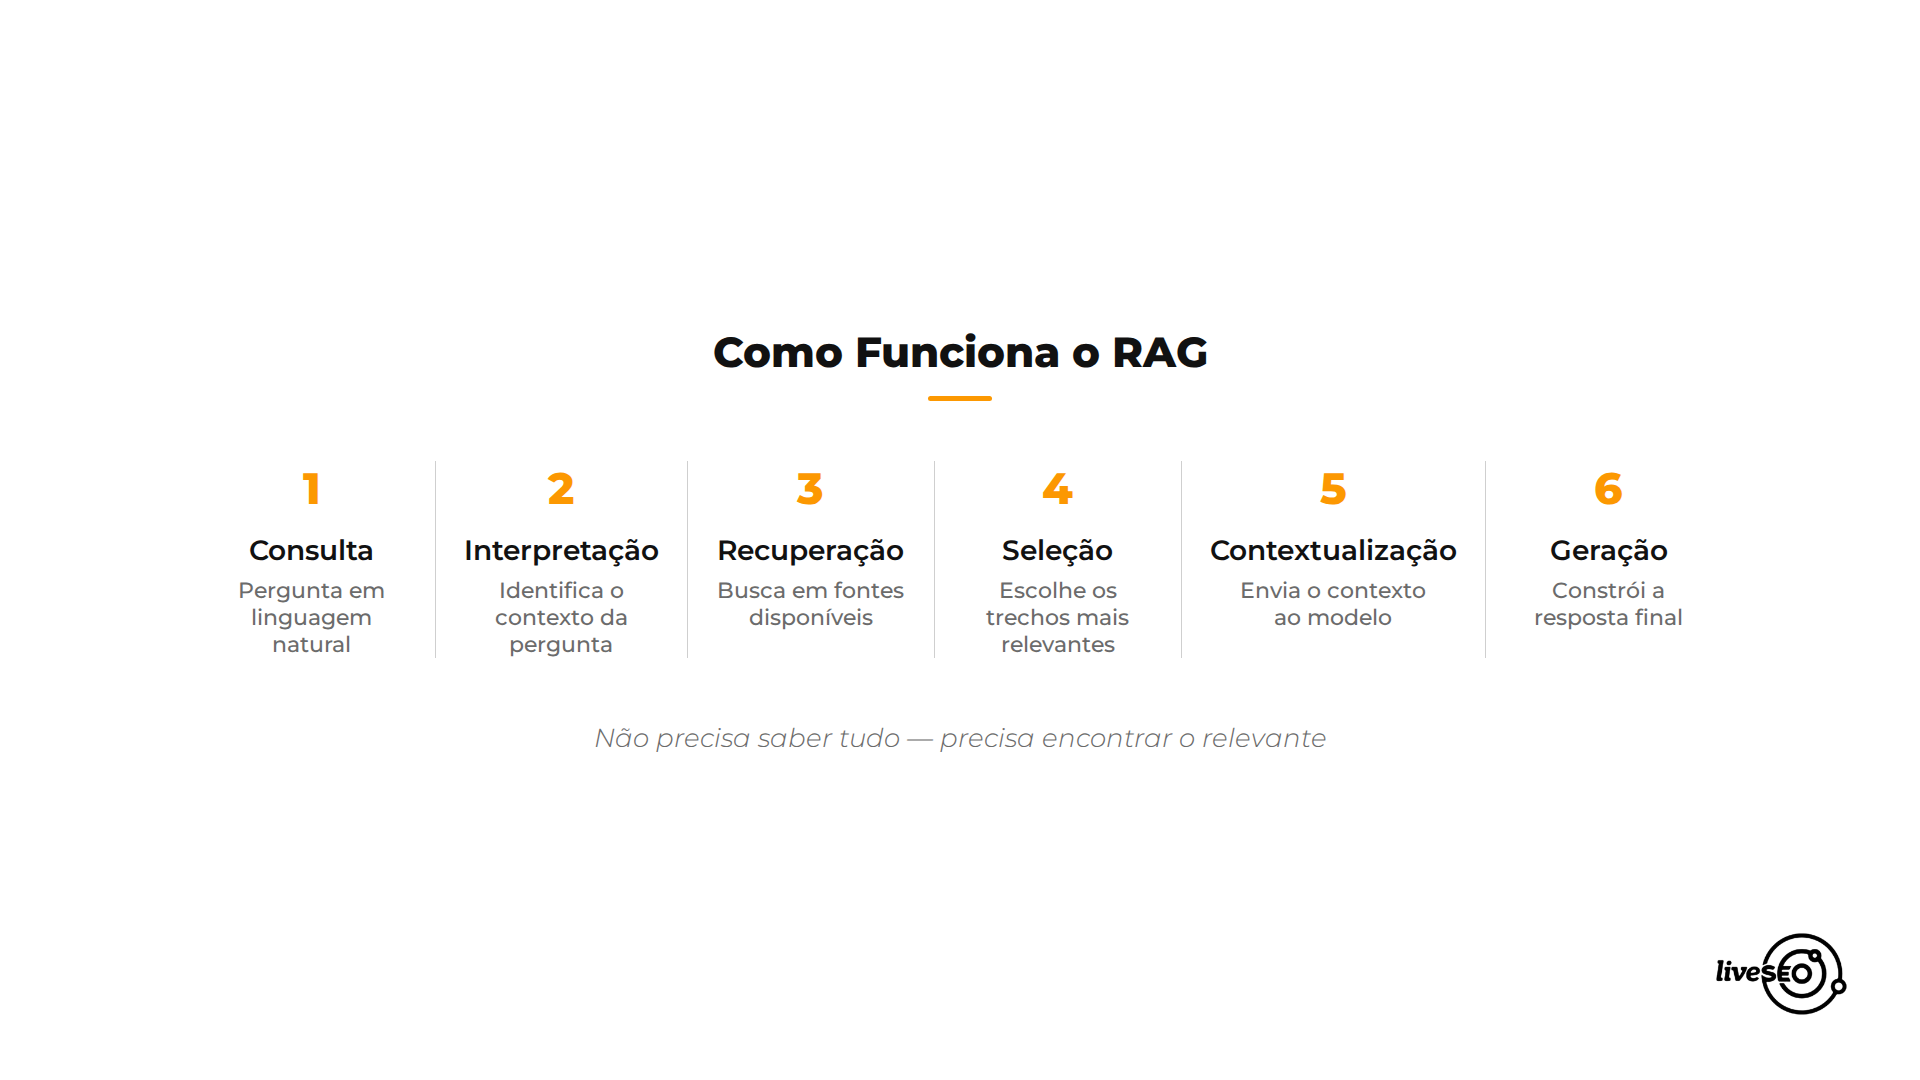
O funcionamento do RAG pode ser dividido em seis etapas: consulta, interpretação, recuperação, seleção, contextualização e geração.
- A consulta é realizada: tudo começa quando o usuário faz uma pergunta ou apresenta uma necessidade em linguagem natural. Essa consulta é o ponto de partida para todo o processo de recuperação.
- A consulta é interpretada: o sistema analisa o significado da pergunta e identifica os elementos mais importantes para determinar quais informações precisam ser encontradas. O objetivo não é considerar apenas as palavras utilizadas, mas entender o contexto da consulta;
- Informações relevantes são recuperadas: a partir dessa interpretação, o sistema consulta as fontes disponíveis, que podem incluir bases de conhecimento, documentos internos, bancos de dados ou conteúdos da web. Essa etapa busca encontrar informações potencialmente úteis para responder à pergunta;
- Os conteúdos mais relevantes são selecionados: nem tudo o que foi recuperado será utilizado. O sistema avalia os resultados e seleciona os trechos que apresentam maior relação com a consulta, reduzindo o conjunto de informações que será levado para a próxima etapa;
- O contexto é enviado ao modelo: os trechos selecionados são apresentados ao modelo como contexto. Eles funcionam como uma base de informação para orientar a geração da resposta, complementando o conhecimento que o modelo já possui;
- A resposta é gerada: por fim, o modelo combina o contexto recuperado com sua capacidade de processamento de linguagem para construir uma resposta coerente e adequada à consulta original.
O ponto estratégico do RAG está justamente nessa mudança: o modelo não precisa ter toda a informação armazenada antecipadamente. Ele precisa conseguir encontrar a informação relevante quando ela for necessária.
RAG não é o mesmo que treinar uma IA
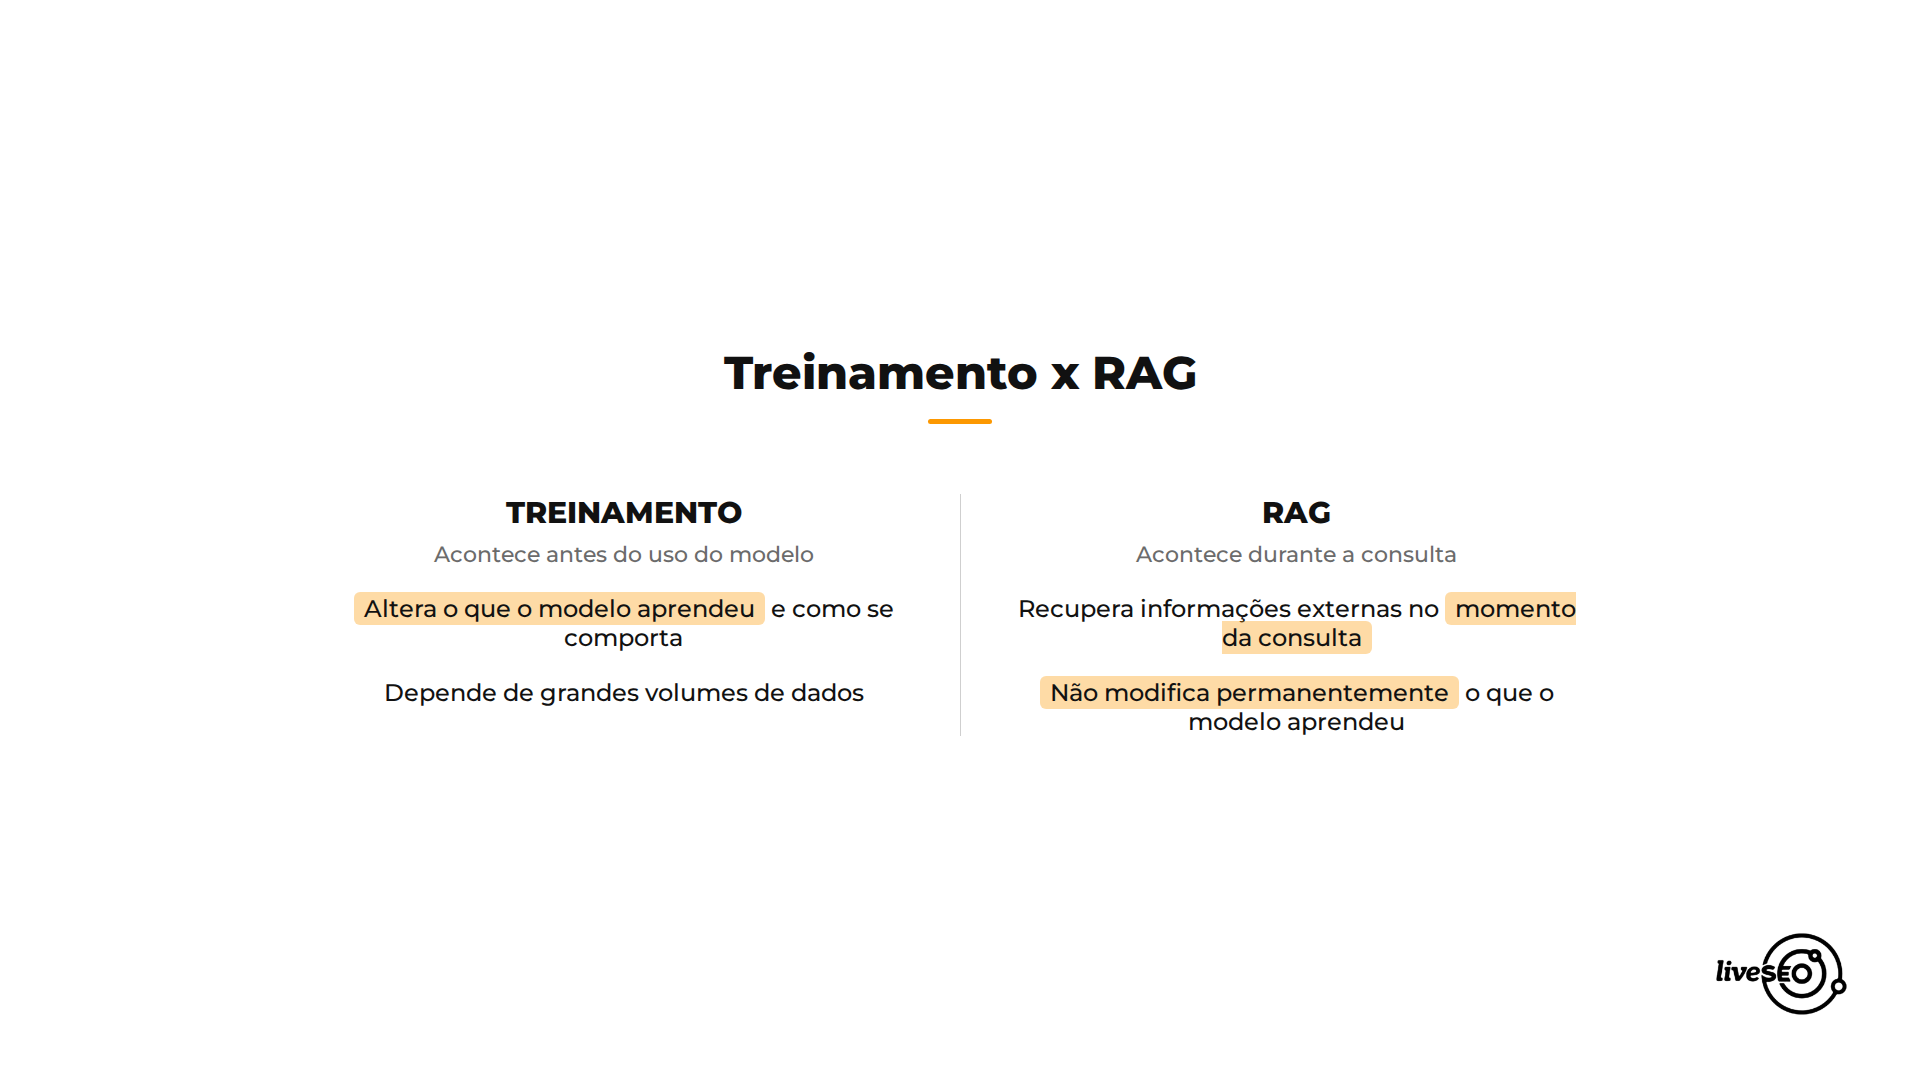
Treinar uma IA e usar RAG são processos diferentes. O treinamento altera o que o modelo aprende e como ele se comporta. Já o RAG recupera informações externas no momento da consulta e fornece esse conteúdo ao modelo como contexto, sem modificar permanentemente o que ele aprendeu.
O treinamento acontece antes do uso do modelo e depende de grandes volumes de dados e capacidade computacional. O RAG, por outro lado, acontece durante a consulta: o sistema busca informações em fontes disponíveis, seleciona o que é relevante e utiliza esse material para construir a resposta.
Essa diferença tem uma implicação importante para marcas. Uma informação não precisa necessariamente fazer parte do treinamento de um modelo para ser utilizada em uma resposta. Dependendo da arquitetura do sistema, o conteúdo pode ser recuperado de uma fonte externa no momento em que a consulta acontece.
É justamente aqui que RAG se conecta ao GEO: a visibilidade de uma marca não depende apenas de ter seu conteúdo incorporado ao conhecimento de um modelo, mas também de estar presente em fontes que os sistemas conseguem encontrar e recuperar quando precisam responder a uma consulta.
Como o RAG encontra os conteúdos relevantes?
Para recuperar informações, um sistema de RAG pode combinar diferentes mecanismos de busca. A escolha depende da arquitetura utilizada e do tipo de informação que precisa ser encontrada.
Entre as principais abordagens estão:
- Busca por palavras e termos: encontra correspondências diretas entre os termos da consulta e aqueles presentes no conteúdo;
- Correspondência semântica: considera o significado da consulta, mesmo quando as palavras utilizadas são diferentes das presentes no conteúdo;
- Embeddings: representam textos e outros dados em formato numérico, permitindo comparar conteúdos a partir de sua proximidade semântica;
- Busca vetorial: utiliza embeddings para encontrar conteúdos semanticamente relacionados à consulta.
- Busca híbrida: combina diferentes mecanismos, como correspondência por termos e busca semântica, para ampliar a capacidade de recuperação.
Essa diferença é importante porque mostra que recuperar uma informação não significa necessariamente procurar uma palavra exata em uma página. Dependendo do sistema, a relação de significado entre a consulta e o conteúdo também pode determinar o que será recuperado.
Entre essas abordagens, embeddings e busca vetorial merecem atenção especial porque introduzem uma lógica de recuperação baseada em proximidade semântica.
O que faz um conteúdo ser mais fácil de recuperar?
Não existem fatores de ranqueamento para RAG no sentido tradicional do SEO. O que existe são características que tornam uma informação mais clara, contextualizada e potencialmente mais recuperável por sistemas de IA.
- Informação objetiva: dados, fatos, definições e afirmações precisam estar explícitos no conteúdo. Quanto mais uma informação depender de interpretação ou de leitura nas entrelinhas, mais difícil é isolá-la e utilizá-la fora do contexto original;
- Estrutura clara: headings tags, subtítulos, listas e uma organização lógica ajudam a separar diferentes informações dentro de uma mesma página. Isso facilita a identificação de trechos específicos quando o sistema precisa recuperar apenas uma parte do conteúdo;
- Contexto suficiente: uma informação pode fazer sentido dentro de uma página e perder significado quando é retirada dela. Por isso, é importante deixar claro quem, o quê, quando, onde e em qual situação determinada afirmação é válida;
- Consistência: informações conflitantes dentro do próprio site ou entre diferentes fontes dificultam a identificação de qual versão deve ser considerada confiável. Manter dados e afirmações consistentes reduz essa ambiguidade;
- Atualização: para informações que mudam com frequência, como preços, disponibilidade e dados de mercado, estar acessível não é suficiente. Um conteúdo desatualizado pode perder utilidade rapidamente para um sistema que precisa responder com informações atuais;
- Relação entre conceitos e entidades: explicar as relações entre pessoas, empresas, produtos, conceitos e acontecimentos ajuda a construir o contexto necessário para compreender do que aquela informação trata e em quais consultas ela pode ser relevante;
Esses princípios não formam uma receita para aparecer em respostas de IA. Eles ajudam a construir conteúdos mais organizados, compreensíveis e contextualizados, características que podem favorecer sua recuperação por sistemas de IA e que, ao mesmo tempo, melhoram a experiência de leitura para as pessoas.
RAG muda a forma como pensamos conteúdo para SEO?
O SEO tradicional trabalha com uma lógica relativamente linear: uma consulta leva a uma página, a página disputa posições nos resultados e o usuário decide onde clicar.
Em experiências baseadas em IA, existe uma camada adicional. Uma necessidade pode levar à recuperação de informações em diferentes fontes, à seleção dos trechos mais relevantes e, a partir desse contexto, à construção de uma resposta.
Isso significa que a página deixa de ser necessariamente a única unidade de valor. Um sistema de recuperação pode encontrar um trecho específico de uma página para responder a uma consulta, sem utilizar todo o conteúdo disponível naquele endereço.
O que isso muda para as marcas?
Se sistemas de IA passam a recuperar informações antes de responder, algumas perguntas ganham importância: quais informações sobre a marca estão disponíveis publicamente, onde estão publicadas e quão consistentes e atualizadas elas são?
Isso importa porque uma marca pode participar da jornada de decisão antes mesmo de o usuário visitar seu site. A informação recuperada por um sistema de IA pode influenciar descoberta, consideração, comparação e escolha, mesmo sem gerar uma sessão registrada no analytics.
Por isso, medir o impacto do conteúdo apenas pelo tráfego direto para uma página oferece uma visão incompleta. A presença da marca no processo de decisão mediado por IA também pode ser um resultado, mesmo quando não aparece como uma linha no relatório de sessões.
Entenda como medir o impacto dessa visibilidade e quais indicadores realmente importam em: Como medir resultados de GEO: estratégias e ferramentas.
O que o RAG muda na lógica da busca?
O SEO trabalha com uma lógica relativamente linear: uma consulta leva a uma página, a página disputa posições nos resultados e o usuário decide onde clicar.
Em experiências baseadas em IA, existe uma camada adicional: uma necessidade pode levar à recuperação de informações em diferentes fontes, à seleção dos trechos mais relevantes e, a partir desse contexto, à construção de uma resposta.
Isso não significa que o SEO perdeu importância. Significa que o conteúdo pode ser utilizado em partes, contextos e jornadas diferentes, e não necessariamente como uma página inteira acessada pelo usuário.
Na prática, isso reforça a importância de produzir conteúdos claros, contextualizados e estruturados, em que cada seção tenha valor próprio sem transformar o texto em uma coleção artificial de respostas curtas.
Quer continuar explorando essa nova lógica de SEO e GEO? Confira nosso conteúdo sobre “Brand Sentiment: o que é e como impacta SEO e GEO“.
Até mais!